Встроенная функция ascii() и ее отличие от repr()
Функция ascii() в Python возвращает строковое представление объекта, в котором все символы за пределами таблицы ASCII заменены escape-последовательностями. В статье разобраны правила экранирования, сравнение с repr() и str(), обратное преобразование и практические задачи: поиск невидимых пробелов, отличие латинских букв от похожих кириллических, вывод в терминал без поддержки Unicode.
Содержание статьи
Что делает ascii()
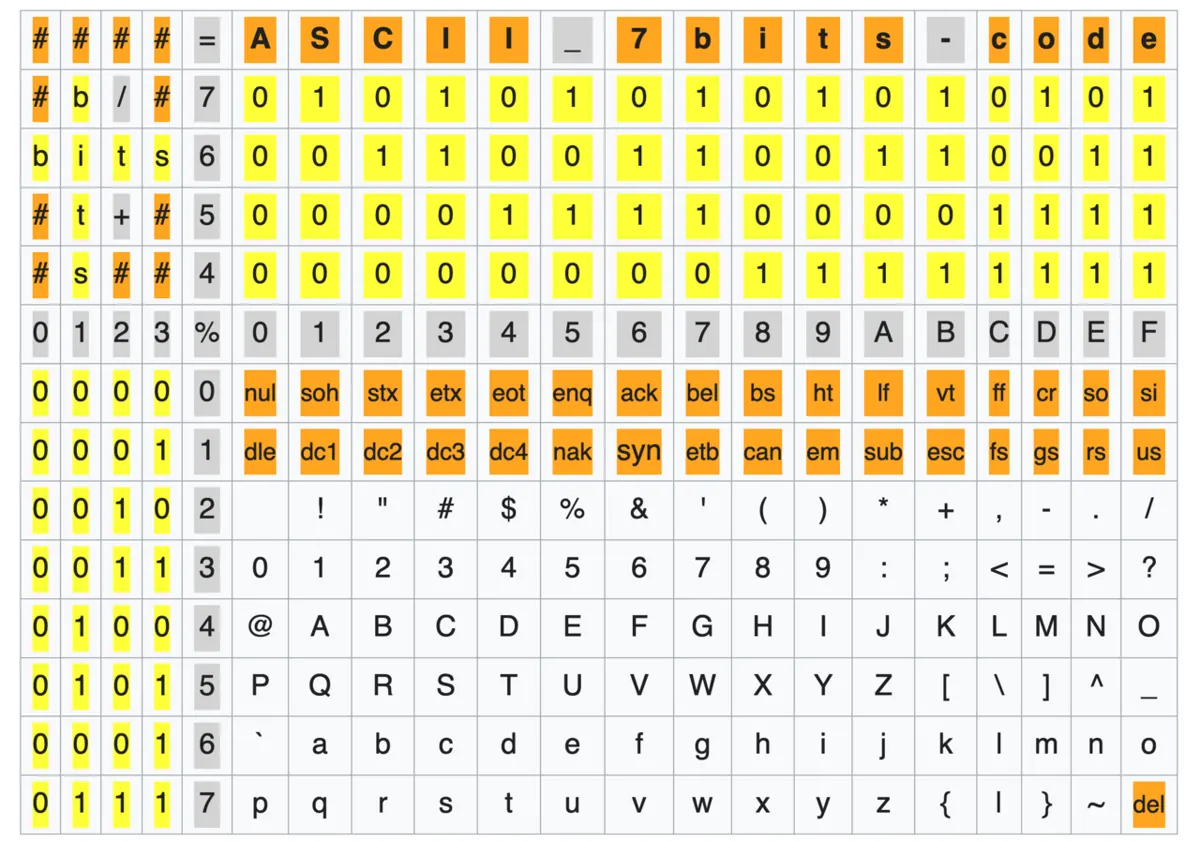
Синтаксис: ascii(obj). Функция принимает один объект любого типа и всегда возвращает строку. Работает она в два шага: сначала получает представление объекта так же, как repr(), затем заменяет в нем каждый символ с кодом больше 127 на escape-последовательность. Символы ASCII, то есть латинские буквы, цифры, знаки препинания и пробел, остаются как есть.
print(ascii("My name is Timur"))   # 'My name is Timur'
print(ascii("My name is Тимур"))   # 'My name is \u0422\u0438\u043c\u0443\u0440'
print(ascii(42))                     # 42
print(ascii(["Python", "Pythön", 5]))  # ['Python', 'Pyth\xf6n', 5]
Обратите внимание на кавычки в результате: для строки функция возвращает ее запись в виде литерала Python, как в исходном коде. Длина результата поэтому больше длины исходной строки: len(ascii("Тимур")) равно 32, а не 5.
Правила экранирования
Вид последовательности зависит от кода символа в Unicode. Все три формы можно вставить обратно в строковый литерал Python, и они превратятся в исходный символ.
| Код символа | Формат | Пример |
|---|---|---|
| 0-31 и 127 (управляющие) | \n, \t или \xhh | перенос строки → \n |
| 32-126 | Без изменений | A, 7, ! |
| 128-255 | \xhh, 2 шестнадцатеричные цифры | ö → \xf6 |
| 256-65535 | \uhhhh, 4 цифры | Т → \u0422 |
| 65536 и выше | \Uhhhhhhhh, 8 цифр | эмодзи 😀 → \U0001f600 |
Управляющие символы экранирует еще repr(), поэтому они выглядят одинаково в обеих функциях. Разница между ними только в символах с кодом от 128: repr() оставляет печатаемые Unicode-символы как есть, а ascii() экранирует все без исключения.
Сравнение ascii(), repr() и str()
Все три функции превращают объект в строку, но для разных целей. str() дает текст для человека, repr() однозначную запись для программиста, ascii() ту же запись, но гарантированно из одних ASCII-символов.
s = "Привет\n"
print(str(s))     # Привет и перенос строки
print(repr(s))    # 'Привет\n'
print(ascii(s))   # '\u041f\u0440\u0438\u0432\u0435\u0442\n'

name = "Ёж"
print(f"{name!a}")      # '\u0401\u0436'
print("%a" % name)      # '\u0401\u0436'
В f-строках и методе format() вызов ascii() заменяет флаг преобразования !a, а в старом форматировании через % спецификатор %a. Это удобно в логах: значение переменной видно вместе с кавычками и скрытыми символами.
Объекты разных типов
Для коллекций функция экранирует элементы внутри представления: ключи и значения словаря, элементы списка и кортежа. Числа, None и логические значения состоят только из ASCII, поэтому не меняются.
print(ascii({"город": "Москва", "code": 77}))
# {'\u0433\u043e\u0440\u043e\u0434': '\u041c\u043e\u0441\u043a\u0432\u0430', 'code': 77}

class Product:
    def __init__(self, title):
        self.title = title
    def __repr__(self):
        return f"Product({self.title!r})"

print(ascii(Product("Чай")))   # Product('\u0427\u0430\u0439')
Отдельного магического метода для ascii() нет: функция всегда берет результат __repr__ и экранирует его. Если в классе __repr__ не определен, вы увидите стандартную запись вида <__main__.Product object at 0x...>.
Практическое применение
Чаще всего ascii() выручает при отладке текста, в котором глазами ошибку не увидеть. Ниже три типичные ситуации.
Поиск невидимых символов
Неразрывный пробел, пробел нулевой ширины или метка порядка байтов в начале файла выглядят как обычный пробел или не видны вовсе, но ломают сравнение строк и парсинг чисел. Функция показывает их явно.
price = "1\xa0500"            # неразрывный пробел из HTML
word = "\ufeffid"              # BOM в начале CSV-файла
print(price, word)             # выглядит как 1 500 id
print(ascii(price), ascii(word))
# '1\xa0500' '\ufeffid'
Похожие буквы из разных алфавитов
Латинская a и кириллическая а выглядят одинаково, но это разные символы. Если поиск по слову не находит очевидное совпадение, сравните строки через ascii(): латиница останется буквой, кириллица превратится в код.
a, b = "cat", "сat"   # во втором слове первая буква кириллическая
print(a == b)          # False
print(ascii(b))        # '\u0441at'
Вывод в терминал без Unicode
Старые консоли и некоторые системы логирования не поддерживают UTF-8, и печать русского текста вызывает UnicodeEncodeError. Вывод через ascii() всегда безопасен, а исходный текст восстанавливается по кодам.
Связанные функции и обратное преобразование
Из результата ascii() можно получить исходную строку функцией ast.literal_eval(): она безопасно разбирает литерал Python. Не используйте для этого eval(), он выполнит любой код.
import ast

coded = ascii("Тимур")
print(ast.literal_eval(coded))                    # Тимур
print("Тимур".encode("ascii", "backslashreplace")) # b'\\u0422\\u0438\\u043c\\u0443\\u0440'
print("Timur".isascii(), "Тимур".isascii())       # True False
print(ord("Т"), hex(ord("Т")), chr(0x422))        # 1058 0x422 Т
Метод str.isascii() (с Python 3.7) проверяет, состоит ли строка только из ASCII. Функция ord() возвращает код одного символа, а обратную операцию выполняет функция chr(). О кодировках и методах encode() и decode() подробнее в статье про кодировку строк, описание самой функции есть в документации Python.
Частые вопросы
Короткие ответы на вопросы о функции ascii().
Как получить ASCII-код символа?
Для этого нужна не ascii(), а ord(): ord("A") вернет 65. Функция работает для любого символа Unicode, для кириллической Т вернет 1058.
Чем ascii() отличается от encode("ascii")?
ascii() возвращает строку с представлением объекта и кавычками. encode("ascii") возвращает байты и на первом же не-ASCII символе выбросит UnicodeEncodeError, если не указать обработчик ошибок, например "backslashreplace" или "ignore".
Почему в результате появились лишние кавычки?
Функция возвращает запись объекта, как ее показал бы repr(), а запись строки включает кавычки. Если нужно экранировать текст без кавычек, используйте s.encode("unicode_escape").decode("ascii").
Можно ли передать в ascii() несколько аргументов?
Нет, функция принимает ровно один объект. Чтобы обработать несколько значений, передайте их в кортеже или вызовите функцию для каждого отдельно.